Diferencias en Diferencias en Test A/B: medir sin sorteo
Sin sortear usuarios, diferencias en diferencias compara la variación del tratado con la del control. Cómo hacer la cuenta y por qué el error engaña.
📚 Este artículo es parte de la guía Significancia Estadística en Tests A/B: La Guía.
Cuando el cambio no cabe en un sorteo de usuario, las dos lecturas obvias se equivocan de signo. En la simulación de esta guía, comparar el grupo tratado consigo mismo antes y después devolvió menos 0,15 punto, comparar el tratado con el control después del cambio devolvió menos 0,25 punto con valor-p de cerca de 3,2 veces 10 elevado a menos 7, y diferencias en diferencias devolvió más 0,25 punto, que era el efecto verdadero. Esta guía muestra cómo armar la cuenta, qué premisa cobra, y por qué su error estándar es el verdadero campo minado: en nuestro placebo, la lectura convencional acusó efecto en el 29,40 por ciento de las veces en que no había efecto ninguno. Forma parte de nuestra guía completa de test A/B y complementa experimentos geográficos y aleatorización por cluster.
El problema: hay cambios que no caben en el sorteo
Un test A/B común sortea al usuario. La mitad ve la versión A, la mitad la B, y la comparación es honesta porque el sorteo garantiza que los dos grupos son iguales en todo, incluso en lo que nadie midió.
Solo que no todo cambio acepta ese sorteo:
- el cambio es del backend por región. Un nuevo transportista que solo opera en ciertos estados, un medio de pago local, una regla fiscal.
- el cambio es de precio. Mostrar precios distintos a usuarios sorteados en el mismo mercado es un problema jurídico y de confianza antes de ser un problema estadístico.
- el cambio es de marca. Campaña de TV, patrocinio, cambio de posicionamiento. No existe versión B para la mitad del país.
- el cambio ya ocurrió. El equipo lo subió, nadie preparó el sorteo, y ahora alguien quiere saber si funcionó.
- la unidad es demasiado grande. Con 12 tiendas u 8 mercados, sortear la mitad deja el poder estadístico cerca de cero, como ya tratamos en aleatorización por cluster.
En esos casos, el cambio entra por un recorte que no elegiste al azar. Y ahí la comparación más natural queda envenenada, porque el recorte tratado ya era distinto del resto antes de que ocurriera nada.
Conviene registrar que la alternativa preferida sigue siendo sortear. Blake, Nosko y Tadelis consiguieron sortear a nivel de mercado en un experimento de medios pagados de eBay y la diferencia entre las lecturas fue brutal: la estimación por mínimos cuadrados ordinarios devolvió retorno sobre inversión por encima del 4.100 por ciento, la misma cuenta con controles de día y de geografía devolvió por encima del 1.400 por ciento, y la lectura experimental devolvió menos 63 por ciento, con intervalo de confianza del 95 por ciento entre menos 124 por ciento y menos 3 por ciento. Diferencias en diferencias es lo que se usa cuando el sorteo no está disponible, no una preferencia sobre él.
Las dos lecturas equivocadas, y la calculadora que confirma las dos
Simulamos un rollout de checkout que solo funcionaba en parte de las plazas. Cuatro números lo resumen todo:
| grupo | antes | después | variación |
|---|---|---|---|
| plazas tratadas | 3,10% | 2,95% | menos 0,15 pp |
| plazas de control | 3,60% | 3,20% | menos 0,40 pp |
De ahí salen dos lecturas obvias, y las dos se equivocan.
Lectura 1, antes y después solo en el tratado. De 3,10 a 2,95 por ciento, es decir, menos 0,15 punto, menos 4,84 por ciento en términos relativos. Veredicto: el cambio empeoró el checkout. Equivocado, porque el mundo entero empeoró en ese intervalo.
Lectura 2, tratado contra control en el periodo de después. 2,95 contra 3,20 por ciento, es decir, menos 0,25 punto, menos 7,81 por ciento. Veredicto: el cambio empeoró el checkout. Equivocado, porque las plazas tratadas ya convertían menos antes.
La lectura 2 es la más peligrosa de las dos, porque pasa un test de significancia. Con 260.000 visitantes en las plazas de control y 240.000 en las tratadas en el periodo de después, pega los cuatro números en la calculadora:
Test z bilateral de dos proporciones. "Sin significancia" casi siempre significa que falta muestra, no que las versiones sean iguales.
Lo que devuelve, y lo que vale la pena comprobar campo a campo:
| campo | control (A) | tratado (B) |
|---|---|---|
| visitantes | 260.000 | 240.000 |
| conversiones | 8.320 | 7.080 |
| tasa | 3,2000% | 2,9500% |
Resultado: diferencia de menos 0,2500 punto, lift relativo de menos 7,81 por ciento y valor-p tan pequeño que la calculadora muestra solo menor que 0,0001. La cuenta detrás de eso es z igual a menos 5,1117, con valor-p de cerca de 3,2 veces 10 elevado a menos 7 e intervalo de confianza del 95 por ciento de la diferencia entre menos 0,3457 y menos 0,1543 punto, que la calculadora redondea a menos 0,3 a menos 0,2 punto. Un resultado limpio, ajustado y completamente engañoso.
Ahora corre la misma calculadora en el periodo de antes, cuando todavía no existía ningún cambio que medir: 9.000 de 250.000 en el control contra 7.130 de 230.000 en el tratado. Devuelve diferencia de menos 0,5000 punto, lift relativo de menos 13,89 por ciento y z igual a menos 9,6031, con valor-p tan pequeño que la calculadora muestra solo menor que 0,0001. La “derrota” ya estaba ahí antes de que existiera tratamiento. La calculadora no se equivocó: respondió con precisión a una pregunta equivocada.
La cuenta, en una línea
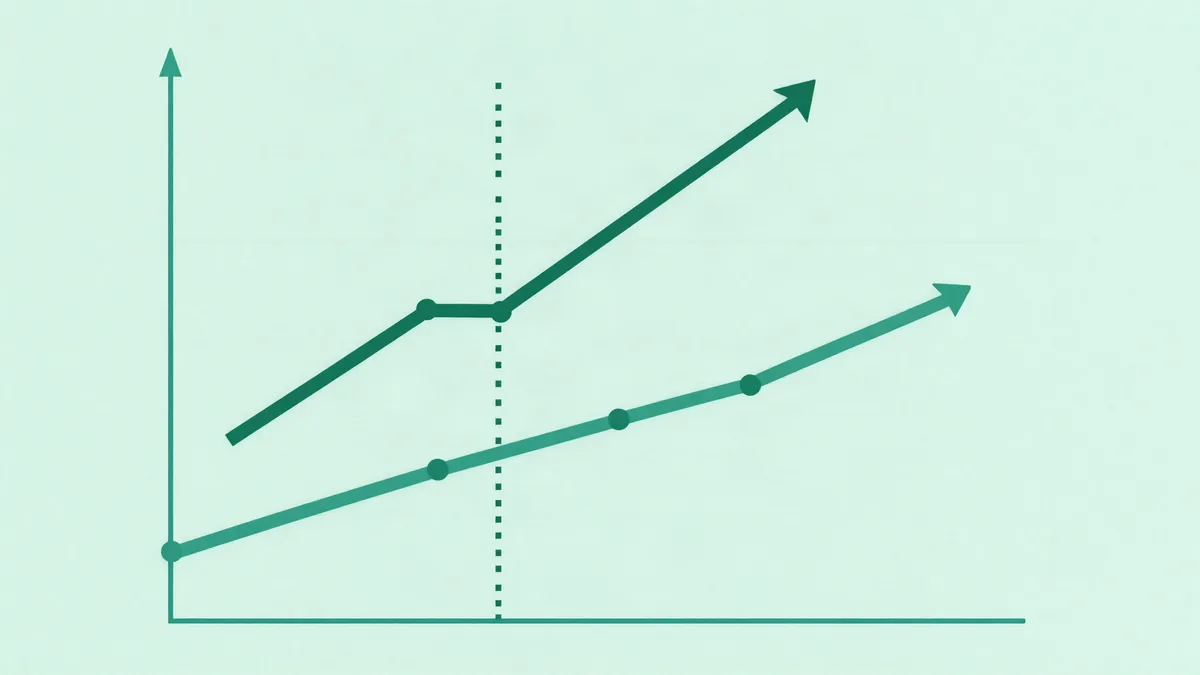
Diferencias en diferencias no compara niveles, compara variaciones:
efecto = (tratado después menos tratado antes) menos (control después menos control antes)
Con nuestros números: (2,95 menos 3,10) menos (3,20 menos 3,60) = (menos 0,15) menos (menos 0,40) = más 0,25 punto.
La forma más útil de leerlo es como una tabla de cuatro celdas, porque deja explícito lo que quita cada resta:
| antes | después | variación | |
|---|---|---|---|
| tratado | 3,10% | 2,95% | menos 0,15 pp |
| control | 3,60% | 3,20% | menos 0,40 pp |
| diferencia | menos 0,50 pp | menos 0,25 pp | más 0,25 pp |
La primera resta, por fila, quita todo lo que es fijo de cada grupo: mix de tráfico, ticket medio, calidad de la base, canal dominante. Si las plazas tratadas siempre convirtieron medio punto menos, ese medio punto sale de la cuenta.
La segunda resta, entre filas, quita todo lo que le ocurrió al mundo en el intervalo: estacionalidad, festivo, competidor en promoción, cambio en el algoritmo de un canal. En nuestro caso, los 0,40 punto de caída que alcanzaron a todos.
Lo que queda es lo que ocurrió solo con el tratado y solo después. Por eso la lectura funciona incluso con grupos de niveles muy distintos: la premisa no es sobre el nivel, es sobre la variación.
El ejemplo clásico de esa lectura es de Card y Krueger. El 1 de abril de 1992, el salario mínimo de Nueva Jersey subió de 4,25 a 5,05 dólares por hora. Encuestaron 410 locales de comida rápida en Nueva Jersey y en el este de Pensilvania, antes y después, y usaron Pensilvania, donde el salario mínimo no cambió, como grupo de control. La ganancia relativa, en sus palabras la “diferencia en diferencias” de las variaciones de empleo, fue de 2,76 empleados equivalentes a tiempo completo, o 13 por ciento, con estadístico t de 2,03.
La premisa: tendencia común, y cómo mirarla
La cuenta solo entrega el efecto causal si vale la tendencia común: en ausencia del cambio, tratado y control habrían variado en la misma medida.
Esa premisa no es testable, porque habla de un mundo que no ocurrió. Pero se vuelve mucho más o mucho menos creíble según lo que se ve antes del cambio. Si las dos series fueron juntas por varios periodos y solo se despegaron cuando entró el cambio, la premisa es razonable. Si ya venían abriéndose, la lectura está muerta.
Tres comprobaciones prácticas, todas baratas:
- Grafica las dos series crudas. Antes de cualquier regresión. Si no van juntas en el gráfico, ninguna sofisticación lo va a arreglar.
- Corre la cuenta en periodos placebo. Finge que el cambio entró dos semanas antes de que entrara, con datos solo del periodo anterior. El resultado debería estar cerca de cero.
- Corre la cuenta en métricas placebo. Una métrica que el cambio no podría haber afectado, por ejemplo la tasa de rebote de la home en un rollout que solo tocó el checkout. Si también “mejoró”, lo que mediste no fue el cambio.
Esa lógica es la misma de los experimentos de validación que tratamos en test A/A: si el método encuentra efecto donde no puede haberlo, el problema es el método.
El error estándar es el verdadero campo minado
El punto estimado de diferencias en diferencias es aritmética simple. El intervalo de confianza a su alrededor es donde casi todo el mundo se hace daño, y el daño es sistemático.
Bertrand, Duflo y Mullainathan revisaron todos los artículos de diferencias en diferencias publicados en seis revistas de economía entre 1990 y 2000, 92 en total. De los 65 que usaban más de dos periodos, solo cinco trataban explícitamente la correlación serial, y cuatro de esos cinco usaban una corrección paramétrica que, como muestran después, casi no cambia nada. Además, 80 de los 92 artículos tenían problema de error agrupado, porque la unidad de observación era más fina que la unidad de variación, y solo 36 lidiaban con eso.
Para medir el estrago, sortearon leyes ficticias en datos de salarios femeninos de la Current Population Survey, mujeres de 25 a 50 años, de 1979 a 1999, cerca de 900 mil observaciones. Como las leyes eran inventadas, cualquier efecto significativo es falso positivo, y la tasa correcta sería del 5 por ciento. Su tabla:
| lectura | tasa de rechazo sin efecto ninguno |
|---|---|
| micro datos, mínimos cuadrados ordinarios | 67,5% |
| micro datos, error estándar agrupado por celda estado-año | 44,0% |
| datos agregados por estado y año | 43,5% |
| ley ficticia SIN correlación serial | 6,0% |
| datos manufacturados con autocorrelación de 0,8 | 37,3% |
La fila decisiva es la cuarta. Cuando construyeron una ley que se enciende y se apaga al azar, sin correlación serial, la tasa de rechazo cayó al 6 por ciento. El problema no es el método, es la combinación de una serie correlacionada consigo misma con una regla de tratamiento también correlacionada consigo misma. En sus datos, la autocorrelación de primer orden de los residuos era de 0,51, y la de segundo y tercer orden, 0,44 y 0,33, cayendo bastante más despacio de lo que un proceso autorregresivo de primer orden preveería.
Reprodujimos el mismo experimento a escala de producto: 40 plazas, 8 tratadas, 4 semanas antes y 4 después, 7.500 visitantes por plaza por semana, con ruido autocorrelacionado dentro de cada plaza.
Con un efecto verdadero de 0,25 punto plantado, la estimación salió en 0,2532 punto, prácticamente encima. Lo que cambia según el error estándar:
| error estándar | valor | t | lectura |
|---|---|---|---|
| calculado por visitante, como si cada visita fuera independiente | 0,03738 pp | 6,775 | confianza exagerada |
| agrupado por plaza | 0,05987 pp | 4,230 | honesto |
| inferencia por permutación, 20.000 sorteos | punto de corte empírico | valor-p 0,0006 | honesto |
El error estándar agrupado por plaza es 1,6 veces el ingenuo. Y el coste de eso aparece de verdad en el placebo: repetimos el procedimiento 2.000 veces sin plantar efecto ninguno, sorteando al azar qué plazas serían “tratadas”.
En nuestra simulación, el error estándar calculado por visitante declaró efecto significativo en el 29,40 por ciento de los sorteos sin efecto ninguno, casi seis veces la tasa correcta. La inferencia por permutación devolvió el 5,15 por ciento, prácticamente encima del 5 por ciento teórico.
La inferencia por permutación es el camino más simple y más robusto, y es exactamente la recomendación principal de Bertrand, Duflo y Mullainathan, por funcionar independientemente del tamaño de la muestra. Cabe en tres pasos:
- Calcula el efecto de diferencias en diferencias con el conjunto real de plazas tratadas.
- Sortea al azar, miles de veces, un conjunto ficticio de plazas tratadas del mismo tamaño, y calcula el efecto de cada sorteo.
- El valor-p es la fracción de los sorteos ficticios cuyo efecto absoluto quedó mayor o igual al real.
En nuestro caso, con 20.000 sorteos, solo 12 de ellos igualaron o superaron el efecto observado: valor-p de 0,0006.
Cuando permutar no sea práctico, las dos alternativas que ellos probaron también funcionan con muchas unidades: colapsar todo en dos periodos, uno antes y uno después, que devolvió un 6 por ciento de rechazo; y permitir una matriz de covarianza arbitraria dentro de cada estado, que en la práctica es agrupar el error estándar por estado y devolvió un 6 por ciento. Las dos se degradan con pocas unidades: en el artículo, el agrupamiento sube al 8,5 por ciento con 10 estados y al 15 por ciento con 6, y la agregación sube al 9,5 por ciento con 20 estados y al 31,5 por ciento con 6.
Cuando el rollout fue escalonado
Hasta aquí todas las plazas tratadas entraron en la misma fecha. En la vida real el rollout suele ser escalonado: un grupo en la semana 3, otro en la 6, otro en la 9. La tentación es echarlo todo en una regresión con efectos fijos de plaza y de semana y leer el coeficiente del indicador de tratamiento.
Goodman-Bacon mostró lo que ese coeficiente realmente es: una media ponderada de todas las comparaciones 2x2 posibles entre grupos de fechas de entrada. Algunas de esas comparaciones son las que esperabas, tratado contra nunca tratado. Otras usan un grupo tratado antes como control de un grupo tratado después, en el intervalo en que el primero ya está tratado.
En palabras de Goodman-Bacon, cuando los efectos no cambian a lo largo del tiempo, la lectura devuelve una media ponderada por la varianza de los efectos entre grupos y todos los pesos son positivos. Los pesos negativos solo aparecen cuando el efecto varía a lo largo del tiempo: cuando unidades ya tratadas hacen el papel de control, el cambio de su efecto a lo largo del tiempo es restado de la estimación. Él registra que eso no implica un fallo del diseño, pero que sirve de alerta contra resumir efectos que varían en el tiempo en un coeficiente único.
Los pesos, muestra, son proporcionales al tamaño de los grupos y a la varianza del indicador de tratamiento en cada par, y esa varianza es mayor para quien fue tratado en medio del panel. Es decir: quien entró en medio del rollout domina el resultado, sin que nadie lo haya decidido.
En la práctica, para un rollout escalonado:
- No leas un coeficiente único. Estima un efecto por periodo desde la entrada, el llamado estudio de eventos, y mira el formato de la curva.
- Prefiere estimadores que solo usan controles limpios, es decir, que comparan cada grupo tratado únicamente con quien todavía no fue tratado.
- Si vas a usar un solo número, di quién lo dominó. Un coeficiente cuyo peso está casi todo en el grupo del medio no es “el efecto del rollout”.
Ruta de diferencias en diferencias en siete pasos
- Escribe la pregunta antes de mirar los datos. Qué cambio, qué métrica, qué recorte tratado, qué fecha de corte. Eso va al plan de análisis preregistrado igual que en un test sorteado.
- Elige el grupo de control por la tendencia, no por el nivel. El mejor control no es el más parecido en conversión, es el que varió junto con el tratado en los periodos anteriores.
- Grafica las series crudas de los dos grupos antes de calcular nada. Si el gráfico no convence, el número no va a convencer.
- Corre periodos placebo y métricas placebo. Un resultado grande donde no puede haber efecto tumba la lectura.
- Calcula las cuatro medias y haz la resta doble. Eso es aritmética y lleva minutos.
- No uses el error estándar por visitante. Usa permutación, o agrupa por unidad de tratamiento, o colapsa en dos periodos. Di en el informe cuál de los tres usaste.
- Si el rollout fue escalonado, publica la curva por periodo, no un coeficiente único.
Errores comunes
- Comparar tratado y control solo en el periodo de después. Es la lectura 2 de esta guía. Devuelve el signo invertido cuando los niveles ya diferían, y lo devuelve con un valor-p bonito.
- Comparar el tratado consigo mismo antes y después. Eso atribuye al cambio todo lo que ocurrió en el mundo en el intervalo, incluidas estacionalidad y competidores.
- Elegir el control después de ver el resultado. Con diez candidatos a control, uno de ellos devuelve el número que querías. Elegir por tendencia previa, y elegir antes, es lo que separa medición de justificación.
- Usar el error estándar que ofrece la herramienta de test A/B. Presupone sorteo por usuario e independencia entre visitas. Aquí no vale ni una cosa ni la otra.
- Creer que la comprobación de SRM en el reparto de tráfico cubre esto. El SRM compara tamaños de grupos sorteados. Aquí no hubo ningún sorteo.
- Ignorar composición que cambia en medio. Si el mix de tráfico de las plazas tratadas cambió entre antes y después por otro motivo, la resta doble no lo elimina.
- Tratar el resultado como si fuera de un test sorteado. Diferencias en diferencias es la segunda mejor opción. Cuando se puede sortear, sortea, y usa la calculadora de tamaño de muestra para saber cuánto tiempo lleva.
- Aplicar la lectura cuando el propio tratamiento cambió el grupo de control. Si las plazas tratadas robaron demanda a las de control, mediste la diferencia más la fuga, un caso de interferencia entre variantes.
Haz esto automático con Donnu
El motivo más común de que una lectura de diferencias en diferencias salga mal no es la fórmula, es el dato. La cuenta necesita la métrica por unidad de tratamiento y por periodo, guardada con la misma definición antes y después. Un panel que solo guarda el total agregado del sitio, o que cambió la definición de conversión a mitad de camino, no permite la lectura, y ninguna sofisticación estadística lo arregla después.
Donnu guarda el resultado por unidad y por día con la definición sellada, lo que convierte la lectura de diferencias en diferencias en una consulta, no en una reconstrucción. Y, más importante, existe para el caso en que sí se puede sortear: siempre que el cambio quepa en un sorteo de usuario, ese es el camino, porque prescinde de la premisa de tendencia común y del campo minado del error estándar. Para saber si tu tráfico soporta el test sorteado antes de irte al cuasi-experimento, la calculadora de tamaño de muestra responde en segundos, y la calculadora de significancia cierra la lectura al final.
Referencias
- Bertrand, M., Duflo, E. y Mullainathan, S. How Much Should We Trust Differences-in-Differences Estimates? NBER Working Paper 8841, 2002, publicado en el Quarterly Journal of Economics. Fuente de la revisión de los 92 artículos de diferencias en diferencias publicados en seis revistas entre 1990 y 2000, de los cuales 65 usaban más de dos periodos y solo cinco trataban explícitamente la correlación serial, y de los cuales 80 tenían problema de error agrupado con solo 36 lidiando con ello; de las tasas de rechazo de la Tabla 2 con leyes ficticias en datos de la Current Population Survey de 1979 a 1999 (67,5 por ciento en micro datos con mínimos cuadrados ordinarios, 44,0 por ciento con agrupamiento por celda estado-año, 43,5 por ciento con datos agregados, 6,0 por ciento con ley sin correlación serial y 37,3 por ciento en datos manufacturados con autocorrelación de 0,8); de las autocorrelaciones de residuo de 0,51, 0,44 y 0,33; y de las tasas de las tres correcciones, incluido el 6 por ciento para la agregación en dos periodos y para la matriz de covarianza arbitraria, con degradación al 8,5 y 15 por ciento con 10 y 6 estados en el agrupamiento y al 9,5 y 31,5 por ciento con 20 y 6 estados en la agregación. nber.org.
- Card, D. y Krueger, A. B. Minimum Wages and Employment: A Case Study of the Fast-Food Industry in New Jersey and Pennsylvania. American Economic Review 84(4), 1994. Fuente del ejemplo clásico: el 1 de abril de 1992 el salario mínimo de Nueva Jersey subió de 4,25 a 5,05 dólares por hora, 410 locales de comida rápida de Nueva Jersey y del este de Pensilvania fueron encuestados antes y después, y la ganancia relativa, la diferencia en diferencias de las variaciones de empleo, fue de 2,76 empleados equivalentes a tiempo completo, o 13 por ciento, con estadístico t de 2,03. davidcard.berkeley.edu.
- Goodman-Bacon, A. Difference-in-Differences with Variation in Treatment Timing. NBER Working Paper 25018, versión de julio de 2019, publicado en el Journal of Econometrics. Fuente de que el estimador con efectos fijos de dos sentidos equivale a una media ponderada de todas las comparaciones 2x2 posibles entre grupos de fechas de entrada, incluidas las que usan unidades ya tratadas como control; de que los pesos son proporcionales al tamaño de los grupos y a la varianza del indicador de tratamiento en cada par, siendo mayores para quien fue tratado en medio del panel; y de que los pesos negativos solo aparecen cuando el efecto varía a lo largo del tiempo, caso en el que la variación del efecto en el grupo ya tratado es restada de la estimación, lo que no implica un fallo del diseño pero desaconseja resumirlo todo en un coeficiente único. vanderbilt.edu.
- Blake, T., Nosko, C. y Tadelis, S. Consumer Heterogeneity and Paid Search Effectiveness: A Large Scale Field Experiment. NBER Working Paper 20171, 2014, publicado en Econometrica. Fuente del contraste entre lecturas: retorno sobre inversión por encima del 4.100 por ciento por mínimos cuadrados ordinarios, por encima del 1.400 por ciento con controles de tiempo y geografía, y menos 63 por ciento por la variación experimental, con intervalo de confianza del 95 por ciento entre menos 124 y menos 3 por ciento; y del diseño geográfico con 68 áreas de mercado donde los medios fueron suspendidos, 65 áreas de control emparejadas por correlación serial histórica de ventas y 77 demás áreas de control. nber.org.
Lee también: Experimentos geográficos · Aleatorización por cluster · Test switchback · Unidad de aleatorización · Plan de análisis preregistrado · Calculadora de tamaño de muestra · Leia em português
Preguntas frecuentes
- ¿Qué es diferencias en diferencias?
- Es una lectura que compara la VARIACIÓN de un grupo tratado entre antes y después con la VARIACIÓN de un grupo de control en el mismo intervalo. El efecto estimado es la diferencia entre esas dos variaciones. Sirve para el caso en que no se puede sortear usuarios y el grupo tratado ya era distinto del control antes del cambio.
- ¿Por qué no basta comparar el tratado con el control después del cambio?
- Porque la diferencia de nivel entre los dos grupos ya existía antes. En la simulación de esta guía, el grupo tratado convertía al 3,10 por ciento y el control al 3,60 por ciento antes de cualquier cambio. Comparar 2,95 por ciento con 3,20 por ciento después devuelve menos 0,25 punto con valor-p de cerca de 3,2 veces 10 elevado a menos 7, una derrota estadísticamente significativa que nunca existió.
- ¿Cuál es la premisa que exige diferencias en diferencias?
- Tendencia común: en ausencia del cambio, los dos grupos habrían variado en la misma dirección y en la misma magnitud. La premisa es sobre la VARIACIÓN, no sobre el nivel, así que grupos con niveles muy distintos siguen sirviendo. No es directamente testable, pero se vuelve más creíble cuando las tendencias de los dos grupos van juntas en varios periodos antes del cambio.
- ¿Por qué el error estándar de diferencias en diferencias suele estar mal?
- Porque la serie de cada plaza está correlacionada consigo misma a lo largo del tiempo, y la regla de tratamiento también. Bertrand, Duflo y Mullainathan mostraron que, con cerca de 20 años de datos y leyes ficticias sorteadas al azar, la lectura convencional rechazaba la hipótesis nula al nivel del 5 por ciento en hasta el 45 por ciento de las simulaciones. En la simulación de esta guía, el error estándar calculado por visitante produjo un 29,40 por ciento de falsos positivos.
- ¿Cómo se corrige el error estándar?
- Bertrand, Duflo y Mullainathan probaron tres caminos. Colapsar los datos en dos periodos, antes y después, devolvió un 6 por ciento de rechazo. Permitir una matriz de covarianza arbitraria dentro de cada estado, que en la práctica es agrupar el error estándar por estado, devolvió un 6 por ciento. Y la inferencia por permutación, que recomiendan por funcionar en cualquier tamaño de muestra, es rebarajar quién fue tratado. En la simulación de esta guía devolvió un 5,15 por ciento de falso positivo contra el 5 por ciento teórico.
- ¿Diferencias en diferencias funciona cuando el rollout fue escalonado?
- Funciona con cuidado. Goodman-Bacon mostró que la regresión con efectos fijos de dos sentidos, cuando las unidades son tratadas en fechas distintas, equivale a una media ponderada de todas las comparaciones 2x2 posibles, y algunas de ellas usan unidades YA tratadas como control. Cuando el efecto cambia a lo largo del tiempo, esas comparaciones entran con peso negativo y el coeficiente único deja de resumir lo que se quiere medir.